
시자의 철학까지 담은 머신러닝/딥러닝 핵심 원리와 실무 기법, 텐서플로, 파이토치, JAX, 케라스를 활용한 딥러닝 실전 지침서

딥러닝의 기본 원리부터 생성형 AI까지
단 한 권의 딥러닝 책을 선택한다면 바로 이 책이다!
전 세계 개발자와 연구자가 선택한 『케라스 창시자에게 배우는 딥러닝』이 최신 기술과 실전 예제를 대폭 보강한 개정 3판으로 돌아왔다. 케라스 창시자인 프랑소와 숄레와 핵심 관리자인 매튜 왓슨이 딥러닝의 기본 원리부터 최신 생성형 AI까지 명쾌하게 설명한다. 케라스 3를 중심으로 텐서플로, 파이토치, JAX를 활용해 이미지 분류·분할, 객체 탐지, 시계열 예측, 자연어 처리와 트랜스포머를 알아본다. 그리고 미니 GPT와 디퓨전 모델을 직접 구축하고, LoRA, RLHF, RAG 등 최신 LLM 기술도 살펴본다. 여기에 다중 GPU와 TPU를 활용한 분산 훈련, 혼합 정밀도, 양자화 등 실무 기법은 물론 딥러닝의 한계와 AI의 미래까지 폭넓게 다룬다. 딥러닝의 원리부터 최신 생성형 AI와 실전 모델링까지 한 권으로 익히고 싶은 독자를 위한 완벽한 지침서다.
* 박해선 역자의 동영상 강의: https://bit.ly/kerasdl3
목차
1장. 딥러닝이란 무엇인가?
1.1 인공 지능과 머신러닝, 딥러닝
1.2 인공 지능
1.3 머신러닝
1.4 데이터에서 표현을 학습하기
1.5 딥러닝에서 ‘딥’이란 무엇일까?
1.6 그림 3개로 딥러닝의 작동 원리 이해하기
1.7 딥러닝의 특별한 점
1.8 생성형 AI의 시대
1.9 지금까지 딥러닝의 성과
1.10 단기적 과대 선전에 주의하세요
1.11 여름은 겨울로 바뀔 수 있습니다
1.12 AI에 대한 전망
2장. 신경망의 수학적 구성 요소
2.1 신경망과의 첫 만남
2.2 신경망을 위한 데이터 표현
__2.2.1 스칼라(랭크- 0 텐서)
__2.2.2 벡터(랭크-1 텐서)
__2.2.3 행렬(랭크-2 텐서)
__2.2.4 랭크-3 이상의 텐서
__2.2.5 핵심 속성
__2.2.6 넘파이로 텐서 조작하기
__2.2.7 배치 데이터
__2.2.8 텐서의 실제 사례
2.3 신경망의 톱니바퀴: 텐서 연산
__2.3.1 원소별 연산
__2.3.2 브로드캐스팅
__2.3.3 텐서 곱셈
__2.3.4 텐서 크기 변환
__2.3.5 텐서 연산의 기하학적 해석
__2.3.6 딥러닝의 기하학적 해석
2.4 신경망의 엔진: 그레이디언트 기반 최적화
__2.4.1 도함수란
__2.4.2 텐서 연산의 도함수: 그레이디언트
__2.4.3 확률적 경사 하강법
__2.4.4 도함수 연결: 역전파 알고리즘
2.5 첫 번째 예제 다시 살펴보기
__2.5.1 첫 번째 예제를 밑바닥부터 다시 구현하기
__2.5.2 훈련 스텝 실행하기
__2.5.3 전체 훈련 루프
__2.5.4 모델 평가하기
2.6 요약
3장. 텐서플로, 파이토치, JAX 그리고 케라스에 대한 소개
3.1 딥러닝 프레임워크의 간략한 역사
3.2 프레임워크 사이의 관계
3.3 텐서플로 소개
__3.3.1 텐서플로 첫걸음
__3.3.2 엔드-투-엔드 예제: 순수 텐서플로로 구현하는 선형 분류기
__3.3.3 텐서플로 방식의 차별점
3.4 파이토치 소개
__3.4.1 파이토치 첫걸음
__3.4.2 엔드-투-엔드 예제: 순수 파이토치로 구현하는 선형 분류기
__3.4.3 파이토치 방식의 차별점
3.5 JAX 소개
__3.5.1 JAX 첫걸음
__3.5.2 JAX의 텐서
__3.5.3 JAX의 난수 생성
__3.5.4 엔드-투-엔드 예제: 순수 JAX로 구현하는 선형 분류기
__3.5.5 JAX 방식의 차별점
3.6 케라스 소개
__3.6.1 케라스 첫걸음
__3.6.2 층: 딥러닝의 구성 요소
__3.6.3 층에서 모델로
__3.6.4 ‘컴파일’ 단계: 학습 과정 설정
__3.6.5 손실 함수 선택하기
__3.6.6 fit( ) 메서드 이해하기
__3.6.7 검증 데이터에서 손실과 평가 지표 모니터링하기
__3.6.8 추론: 훈련한 모델 사용하기
3.7 요약
4장. 분류와 회귀
4.1 영화 리뷰 분류: 이진 분류 문제
__4.1.1 IMDB 데이터셋
__4.1.2 데이터 준비
__4.1.3 모델 만들기
__4.1.4 훈련 및 검증
__4.1.5 훈련된 모델로 새로운 데이터에 대해 예측하기
__4.1.6 추가 실험
__4.1.7 정리
4.2 뉴스 기사 분류: 다중 분류 문제
__4.2.1 로이터 데이터셋
__4.2.2 데이터 준비
__4.2.3 모델 만들기
__4.2.4 훈련 및 검증
__4.2.5 새로운 데이터에 대해 예측하기
__4.2.6 레이블과 손실을 다루는 다른 방법
__4.2.7 중간층을 충분히 크게 만들어야 하는 이유
__4.2.8 추가 실험
__4.2.9 정리
4.3 주택 가격 예측: 회귀 문제
__4.3.1 캘리포니아 주택 가격 데이터셋
__4.3.2 데이터 준비
__4.3.3 모델 만들기
__4.3.4 훈련 및 K-겹 교차 검증
__4.3.5 새로운 데이터에 대해 예측하기
__4.3.6 정리
4.4 요약
5장. 머신러닝의 기본 요소
5.1 일반화: 머신러닝의 목표
__5.1.1 과소적합과 과대적합
__5.1.2 딥러닝에서 일반화의 본질
5.2 머신러닝 모델 평가
__5.2.1 훈련, 검증, 테스트 세트
__5.2.2 상식 수준의 기준점 넘기
__5.2.3 모델 평가에 대해 유념해야 할 점
5.3 훈련 성능 향상하기
__5.3.1 경사 하강법의 핵심 파라미터 튜닝하기
__5.3.2 더 나은 구조 가정하기
__5.3.3 모델 용량 늘리기
5.4 일반화 성능 향상하기
__5.4.1 데이터셋 큐레이션
__5.4.2 특성 공학
__5.4.3 조기 종료 사용하기
__5.4.4 모델 규제하기
5.5 요약
6장. 일반적인 머신러닝 워크플로
6.1 작업 정의
__6.1.1 문제 정의
__6.1.2 데이터 수집
__6.1.3 데이터 이해
__6.1.4 성공 지표 선택
6.2 모델 개발
__6.2.1 데이터 준비
__6.2.2 평가 방법 선택
__6.2.3 기준 모델 뛰어넘기
__6.2.4 모델 용량 키우기: 과대적합 모델 만들기
__6.2.5 모델 규제와 하이퍼파라미터 튜닝
6.3 모델 배포
__6.3.1 고객에게 작업을 설명하고 기대치 설정하기
__6.3.2 추론 모델 배치하기
__6.3.3 작동 중 모델 모니터링하기
__6.3.4 모델 유지 관리
6.4 요약
7장. 케라스 완전 정복
7.1 다양한 워크플로
7.2 케라스 모델을 만드는 여러 방법
__7.2.1 Sequential 모델
__7.2.2 함수형 API
__7.2.3 Model 서브클래싱
__7.2.4 여러 방식을 혼합하여 사용하기
__7.2.5 작업에 적합한 도구 사용하기
7.3 내장 훈련 루프와 평가 루프 사용하기
__7.3.1 사용자 정의 지표 만들기
__7.3.2 콜백 사용하기
__7.3.3 사용자 정의 콜백 만들기
__7.3.4 텐서보드를 사용한 모니터링과 시각화
7.4 사용자 정의 훈련, 평가 루프 만들기
__7.4.1 훈련 vs 추론
__7.4.2 사용자 정의 훈련 스텝 함수 작성하기
__7.4.3 평가 지표의 저수준 사용법
__7.4.4 fit( ) 메서드를 사용자 정의 루프로 활용하기
__7.4.5 사용자 정의 train_step( ) 함수에서 평가 지표 처리하기
7.5 요약
8장. 이미지 분류
8.1 합성곱 신경망 소개
__8.1.1 합성곱 연산
__8.1.2 최대 풀링 연산
8.2 소규모 데이터셋에서 밑바닥부터 컨브넷 훈련하기
__8.2.1 작은 데이터셋 문제에서 딥러닝의 타당성
__8.2.2 데이터 내려받기
__8.2.3 모델 만들기
__8.2.4 데이터 전처리
__8.2.5 데이터 증강 사용하기
8.3 사전 훈련된 모델 활용하기
__8.3.1 사전 훈련된 모델을 사용한 특성 추출
__8.3.2 사전 훈련된 모델 미세 튜닝하기
8.4 요약
9장. 컨브넷 아키텍처 패턴
9.1 모듈화, 계층화 그리고 재사용
9.2 잔차 연결
9.3 배치 정규화
9.4 깊이별 분리 합성곱
9.5 Xception 유사 모델에 모두 적용하기
9.6 합성곱을 넘어서: 비전 트랜스포머
9.7 요약
10장. 컨브넷이 학습한 것 해석하기
10.1 중간 활성화 시각화
10.2 컨브넷 필터 시각화하기
__10.2.1 텐서플로로 경사 상승법 수행하기
__10.2.2 파이토치로 경사 상승법 수행하기
__10.2.3 JAX로 경사 상승법 수행하기
__10.2.4 필터 시각화 루프
10.3 클래스 활성화의 히트맵 시각화하기
__10.3.1 최상위 클래스에 대한 그레이디언트 계산하기: 텐서플로
__10.3.2 최상위 클래스에 대한 그레이디언트 계산하기: 파이토치
__10.3.3 최상위 클래스에 대한 그레이디언트 계산하기: JAX
__10.3.4 클래스 활성화 히트맵 그리기
10.4 컨브넷의 잠재 공간 시각화하기
10.5 요약
11장. 이미지 분할
11.1 컴퓨터 비전 작업
__11.1.1 이미지 분할 유형
11.2 밑바닥부터 분할 모델 훈련하기
__11.2.1 분할 데이터셋 내려받기
__11.2.2 분할 모델 만들고 훈련하기
11.3 사전 훈련된 분할 모델 사용하기
__11.3.1 SAM 내려받기
__11.3.2 SAM의 작동 방식
__11.3.3 테스트 이미지 준비하기
__11.3.4 포인트로 모델에 프롬프트 주입하기
__11.3.5 박스로 모델에 프롬프트 주입하기
11.4 요약
12장. 객체 탐지
12.1 1단계 vs 2단계 객체 탐지기
__12.1.1 2단계 R-CNN 탐지기
__12.1.2 1단계 탐지기
12.2 밑바닥부터 YOLO 모델 훈련하기
__12.2.1 COCO 데이터셋 내려받기
__12.2.2 YOLO 모델 만들기
__12.2.3 YOLO 모델을 위한 COCO 데이터 준비하기
__12.2.4 YOLO 모델 훈련하기
12.3 사전 훈련된 RetinaNet 탐지기 사용하기
12.4 요약
13장. 시계열 예측
13.1 다양한 종류의 시계열 작업
13.2 온도 예측 문제
__13.2.1 데이터 준비
__13.2.2 상식 수준의 기준점
__13.2.3 기본적인 머신러닝 모델 시도해 보기
__13.2.4 1D 합성곱 모델 시도해 보기
13.3 순환 신경망
__13.3.1 순환 신경망 이해하기
__13.3.2 케라스의 순환 층
__13.3.3 순환 신경망을 최대한 활용하기
__13.3.4 과대적합을 감소하기 위해 순환 드롭아웃 사용하기
__13.3.5 스태킹 순환 층
__13.3.6 양방향 RNN 사용하기
13.4 더 나아가서
13.5 요약
14장. 텍스트 분류
14.1 간략한 자연어 처리의 역사
14.2 텍스트 데이터 준비하기
__14.2.1 문자 토큰화와 단어 토큰화
__14.2.2 부분 단어 토큰화
14.3 집합과 시퀀스
__14.3.1 IMDB 분류 데이터셋 로드하기
14.4 집합 모델
__14.4.1 BoW 모델 훈련
__14.4.2 바이그램 모델 훈련
14.5 시퀀스 모델
__14.5.1 순환 모델 훈련하기
__14.5.2 단어 임베딩 이해하기
__14.5.3 단어 임베딩 사용하기
__14.5.4 단어 임베딩 사전 훈련
__14.5.5 분류를 위해 사전 훈련된 임베딩 사용하기
14.6 요약
15장. 언어 모델과 트랜스포머
15.1 언어 모델
__15.1.1 셰익스피어 언어 모델 훈련하기
__15.1.2 셰익스피어 생성하기
15.2 시퀀스-투-시퀀스 학습
__15.2.1 영어-스페인어 번역
__15.2.2 RNN을 사용한 시퀀스-투-시퀀스 학습
15.3 트랜스포머 아키텍처
__15.3.1 점곱 어텐션
__15.3.2 트랜스포머 인코더 블록
__15.3.3 트랜스포머 디코더 블록
__15.3.4 트랜스포머를 사용한 시퀀스-투-시퀀스 학습
__15.3.5 위치 정보 임베딩하기
15.4 사전 훈련된 트랜스포머를 사용한 분류
__15.4.1 트랜스포머 인코더 사전 훈련하기
__15.4.2 사전 훈련된 트랜스포머 로드하기
__15.4.3 IMDB 영화 리뷰 전처리
__15.4.4 사전 훈련된 트랜스포머 미세 튜닝하기
15.5 트랜스포머가 효과적인 이유는 무엇일까요?
15.6 요약
16장. 텍스트 생성
16.1 시퀀스 생성의 간략한 역사
16.2 미니 GPT 훈련하기
__16.2.1 모델 만들기
__16.2.2 모델 사전 훈련하기
__16.2.3 생성 디코딩
__16.2.4 샘플링 전략
16.3 사전 훈련된 LLM 사용하기
__16.3.1 젬마 모델로 텍스트 생성하기
__16.3.2 지시 미세 튜닝
__16.3.3 LoRA
16.4 LLM 심화 주제
__16.4.1 RLHF
__16.4.2 멀티모달 LLM
__16.4.3 검색 증강 생성
__16.4.4 ‘추론’ 모델
16.5 LLM은 어디로 향하고 있나요?
16.6 요약
17장. 이미지 생성
17.1 이미지 생성을 위한 딥러닝
__17.1.1 이미지의 잠재 공간에서 샘플링하기
__17.1.2 변분 오토인코더
__17.1.3 케라스로 VAE 구현하기
17.2 디퓨전 모델
__17.2.1 Oxford Flowers 데이터셋
__17.2.2 U-Net 잡음 제거 오토인코더
__17.2.3 디퓨전 시간과 디퓨전 스케줄
__17.2.4 훈련 과정
__17.2.5 생성 과정
__17.2.6 사용자 정의 콜백으로 결과 시각화하기
__17.2.7 이제 쇼타임입니다!
17.3 텍스트-투-이미지 모델
__17.3.1 텍스트-투-이미지 모델의 잠재 공간 탐색하기
17.4 요약
18장. 실전 문제 해결을 위한 모범 사례
18.1 모델의 최대 성능을 끌어내기
__18.1.1 하이퍼파라미터 최적화
__18.1.2 모델 앙상블
18.2 다중 장치를 사용한 대규모 모델 훈련
__18.2.1 다중 GPU 훈련
__18.2.2 분산 훈련 구현
__18.2.3 TPU 훈련
18.3 낮은 정밀도로 GPU에서 훈련 및 추론 속도 높이기
__18.3.1 부동 소수점 정밀도 이해하기
__18.3.2 float16 추론
__18.3.3 혼합 정밀도 훈련
__18.3.4 혼합 정밀도에서 손실 스케일링 사용하기
__18.3.5 혼합 정밀도를 넘어서: float8 훈련
__18.3.6 양자화를 사용한 빠른 추론
18.4 요약
19장. AI의 미래
19.1 딥러닝의 한계
__19.1.1 딥러닝 모델은 새로운 것에 적응하는 데 어려움을 겪습니다
__19.1.2 딥러닝 모델은 표현 방식과 잡음에 매우 민감합니다
__19.1.3 딥러닝 모델은 일반화 가능한 프로그램을 학습하기 어렵습니다
__19.1.4 머신러닝 모델의 의인화 위험
19.2 스케일이 필요한 전부는 아닙니다
__19.2.1 자동 기계 vs 지능 에이전트
__19.2.2 지역 일반화 vs 궁극 일반화
__19.2.3 지능의 목적
__19.2.4 일반화의 스펙트럼
19.3 지능을 구축하는 방법
__19.3.1 만화경 가설
__19.3.2 지능의 본질: 추상의 획득과 재조합
__19.3.3 올바른 목표 설정의 중요성
__19.3.4 새로운 목표: 즉각적인 적응
__19.3.5 ARC 프라이즈
__19.3.6 테스트 시점 적응의 시대
__19.3.7 ARC-AGI-2
19.4 누락된 구성 요소: 탐색과 기호
__19.4.1 두 종류의 추상화
__19.4.2 두 종류의 추상화를 조합한 인지
__19.4.3 딥러닝이 추상화 생성에 대한 완전한 솔루션이 아닌 이유
__19.4.4 AI에 대한 다른 접근 방식: 프로그램 합성
__19.4.5 딥러닝과 프로그램 합성을 혼합하기
__19.4.6 모듈식 구성 요소 재조합과 영구 학습
__19.4.7 장기 비전
20장. 결론
20.1 핵심 개념 리뷰
__20.1.1 인공 지능을 위한 다양한 접근 방식
__20.1.2 머신러닝 분야에서 딥러닝이 특별한 이유
__20.1.3 딥러닝에 대해
__20.1.4 핵심 기술
__20.1.5 일반적인 머신러닝 워크플로
__20.1.6 주요 네트워크 구조
20.2 딥러닝의 한계
20.3 앞으로 무엇이 나올까요?
20.4 빠른 변화에 뒤처지지 않기
__20.4.1 캐글의 실전 문제로 연습하기
__20.4.2 아카이브(arXiv)를 통해 최신 논문 읽기
__20.4.3 케라스 생태계 탐험하기
20.5 맺음말
저자&기여자
ㆍ지은이 프랑소와 숄레
- 소개
- 2012년 딥러닝이 학계에서 주목받기 시작할 때부터 이 분야에서 활동했다. 가장 널리 사용되는 딥러닝 라이브러리인 케라스의 창시자다. 케라스는 대학 수업은 물론 구글, 넷플릭스, 스포티파이와 같은 기업, CERN과 NASA 같은 과학 기관에서 사용된다. 최첨단 AI 시스템을 위한 연구소인 Ndea의 공동 설립자이며, 기계 지능을 측정하기 위한 ARC-AGI 챌린지를 만들었다.
ㆍ지은이 매튜 왓슨
- 소개
- 2018년부터 구글에서 제미나이 모델과 구글의 오픈 소스 딥러닝 생태계를 포함하여 다양한 머신러닝 분야에서 일했다. 케라스의 핵심 관리자이며 주로 자연어 처리를 위한 케라스 도구에 초점을 맞추고 있다. 스탠포드 대학교에서 컴퓨터 과학 석사 학위를 받았으며, 스탠포드 그래픽스 연구소에서 절차적 모델링 기술을 연구했다.
ㆍ옮긴이 박해선
- 소개
- 기계공학을 전공했지만 졸업 후엔 줄곧 코드를 읽고 쓰는 일을 했다. Google AI/Cloud GDE, Microsoft AI MVP다. 텐서플로우 블로그(tensorflow.blog)를 운영하고 있고, 머신러닝과 딥러닝에 관한 책을 집필하고 번역하면서 소프트웨어와 과학의 경계를 흥미롭게 탐험하고 있다. 『혼자 만들면서 공부하는 딥러닝』(한빛미디어, 2025), 『혼자 공부하는 머신러닝+딥러닝(개정판)』(한빛미디어, 2025), 『혼자 공부하는 데이터 분석 with 파이썬』(한빛미디어, 2023), 『챗GPT로 대화하는 기술』(한빛미디어, 2023), 『Do it! 딥러닝 입문』(이지스퍼블리싱, 2019)을 집필했다. 『LLM 미세 튜닝, 핵심만 빠르게!』(인사이트, 2026), 『파이토치로 배우는 LLM & AI』(한빛미디어, 2026), 『대규모 언어 모델, 핵심만 빠르게!』(인사이트, 2025), 『머신러닝, 핵심만 빠르게!』(인사이트, 2025), 『밑바닥부터 만들면서 배우는 LLM』(길벗, 2025), 『핸즈온 LLM』(한빛미디어, 2025), 『머신러닝 Q & AI』(길벗, 2025), 『개발자를 위한 수학』(한빛미디어, 2024), 『실무로 통하는 ML 문제 해결 with 파이썬』(한빛미디어, 2024), 『머신러닝 교과서: 파이토치 편』(길벗, 2023), 『스티븐 울프럼의 챗GPT 강의』(한빛미디어, 2023), 『핸즈온 머신러닝 3판』(한빛미디어, 2023), 『만들면서 배우는 생성 딥러닝 2판』(한빛미디어, 2023), 『코딩 뇌를 깨우는 파이썬』(한빛미디어, 2023), 『트랜스포머를 활용한 자연어 처리』(한빛미디어, 2022)를 포함하여 수십여 권의 책을 우리말로 옮겼다.
저작권 안내
인공지능(AI) 기술 또는 시스템을 훈련하기 위해 자료의 전체 내용은 물론 일부도 사용하는 것을 금지합니다.
All materials are protected by copyright law and may not be edited or reproduced in other media without permission.
It is prohibited to use all or part of the materials, including for training artificial intelligence (AI) technologies or systems, without authorization.
연관 프로그램
무료로 사용할 수 있는 정보를 안내해 드리니, 지원이 필요하면 해당 프로그렘 제작사로 문의해 주세요.

구매 도서 인증

케라스 창시자에게 배우는 딥러닝 개정 3판
부가기호 확인하는 방법
- 종이책 :
-
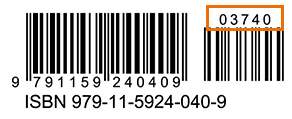
도서 뒷표지 아래쪽에 있는 바코드의 오른쪽 위 숫자
- 전자책(eBook) :
- 전자책 앞 또는 뒷부분의 판권면 (발행인, 담당 편집자 등을 표시하는 곳) 중 ISBN 부분에 표기(예: 979-11-6050-407-1 05320로 된 곳의 뒤 다섯 자리 숫자 05320)
도서문의
케라스 창시자에게 배우는 딥러닝 개정 3판


독자의견 남기기